JevvsClaude API

공식 페이지 확인 · 2026-10-01 / 2026-10-01

Jev와 Claude API를 같은 기준으로 놓았습니다. 두 제품 모두 LLM·판단 모델 API 용도입니다.

Jev

TypeSafe AI

LLM

글이 아니라 타입이 정해진 판단을 돌려주는 의사결정 모델

Claude API

Anthropic

LLM

긴 문맥과 코드 작업에서 많이 쓰이는 상용 LLM API

제품 화면

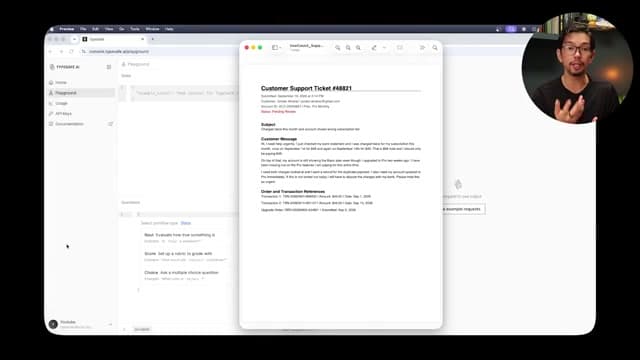
Jev 고객 문의 글을 넣어 분류 결과를 받아 보는 화면

Jev

고객 문의 글을 넣어 분류 결과를 받아 보는 화면

출처 Mikey No Code

사용량 기반 $0.042 / 100만 입력 토큰

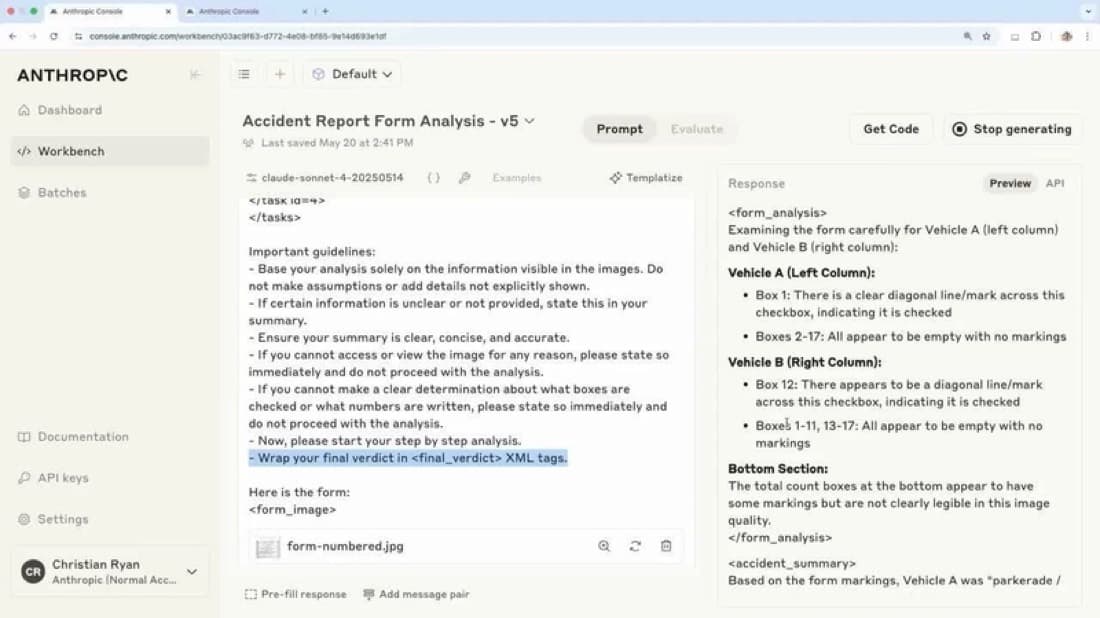
Claude API 콘솔 워크벤치에서 프롬프트를 쓰고 응답을 확인한 뒤 코드로 내보내는 화면

Claude API

콘솔 워크벤치에서 프롬프트를 쓰고 응답을 확인한 뒤 코드로 내보내는 화면

출처 DEV Community

Sonnet 5.5 $2 / 100만 입력 토큰

같은 과금 조건에서 Jev의 표시 요금이 $1.96 낮습니다. 같은 통화·과금 단위의 대표 요금제끼리만 비교한 것입니다. 포함 기능과 사용량이 달라 총비용 차이를 뜻하지는 않습니다.

항목별 비교

써 보니 좋았던 점

Jev사용기

텍스트를 쓰지 않고 판단만 한다 — 분류하고, 점수를 매기고, 확률을 붙여 예·아니오를 낸다. 실사용 영상에서 지원 문의를 넣자 분류와 함께 심각도와 확신도를 즉시 돌려줬고, "이전 지시를 무시하라" 류의 주입 공격을 앞단에서 걸러 내는 용도로도 동작했다. 입력 100만 토큰당 0.042달러에 출력은 무료라, 그 리뷰어는 230만 토큰을 쓰고 10센트가 안 나왔다고 자기 대시보드를 보여 줬다.

Claude API사용기

첫 응답이 빠른 축에 든다 — Haiku 4.5 가 약 597ms 로 측정됐다. 모델 등급이 단순해 고르기 쉽고 긴 문맥과 코드 작업에서 자주 선택된다.

공개된 사용기에서 가져왔습니다. 사용기가 없으면 제품이 밝힌 용도를 적습니다.

써 보니 걸렸던 점

Jev사용기

더 똑똑한 모델이 아니다 — 정확도 비교에서 Sonnet 5 와 비슷한 수준이고 Opus 5 는 여전히 위에 있다. 승부는 정확도가 아니라 비용 축에서 난다. 글을 쓰거나 개념을 설명하는 일은 아예 못 한다. 같은 리뷰어는 첫 연동에서 입력 형태를 잘못 잡아 엉뚱한 결과를 받았고, 문서의 빠른 시작 안내대로 판단 기준을 다시 짠 뒤에야 맞게 동작했다.

Claude API사용기

Sonnet 급은 Gemini Flash 대비 7.5배 비싼데 속도는 더 느리다는 측정이 있다. 비용에 민감한 대량 처리에는 부담이 된다.

실제로 막혔다고 적힌 것만 옮깁니다. 확인된 사용기가 없으면 운영·과금 구조를 적습니다.

이럴 때 맞다

Jev사용기

비싼 모델 앞에 세워 거르고 분류하고 넘기는 앞단. 글을 생성하는 모델을 대체하지는 않는다.

Claude API사용기

응답 품질과 긴 문맥이 중요하고 호출량이 아주 많지는 않은 작업.

어떤 팀·상황에 맞는지입니다.

연결 대상

Jev

API 로 호출해 애플리케이션·에이전트 안에서 씁니다.

Claude API

API 로 호출하며 MCP 로 외부 도구를 붙입니다.

공개된 연동 범위입니다. 목록에 없는 도구는 따로 확인합니다.

시작 조건

Jev

사용량 기반 과금

Claude API

무료 크레딧 없음 · 종량 과금

무료 플랜·체험 여부입니다.

솔루션 비교

LLM·판단 모델 API 용도의 다른 조합입니다.

다른 용도의 솔루션 비교

용도별로 하나씩 골랐습니다.

어느 쪽이 우리 업무에 맞을지 상담해보세요

검토 중인 제품과 개선하려는 업무를 알려주시면 전문가가 적용 범위와 진행 방식을 제안합니다.